

Восстановление 1С в PostgreSQL: полный backup, WAL и проверка целостности
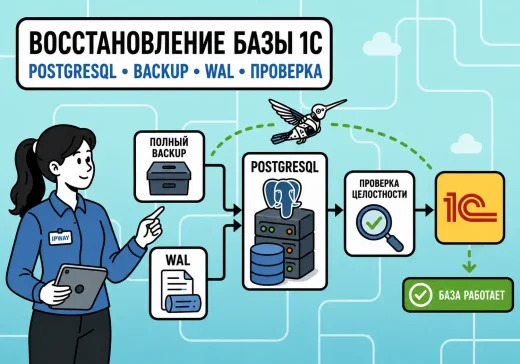
Резервная копия базы 1С нужна не сама по себе. Ее задача — позволить вернуть рабочую информационную базу после сбоя, ошибки администратора, неудачного обновления или повреждения данных.
Именно здесь часто появляется разрыв между «backup есть» и «сервис действительно можно восстановить». Полная копия PostgreSQL может быть создана успешно, но при аварии выясняется, что неизвестно, какую точку выбрать, где лежат WAL, совместима ли копия с текущей версией PostgreSQL и что нужно проверить в самой 1С после запуска базы.
Для клиент-серверной 1С этого особенно мало. Недостаточно добиться состояния, при котором PostgreSQL стартует и принимает подключения. Нужно убедиться, что сервер 1С видит базу, пользователи могут открыть информационную базу, фоновые задания не запускают нежелательные операции, а данные действительно соответствуют выбранному моменту восстановления.
В этой статье разберем recovery-сценарий для 1С на PostgreSQL: чем отличается полный backup от восстановления по WAL, как выбрать правильную точку во времени, что проверить после запуска СУБД и когда базу можно возвращать пользователям.
Как устроено восстановление 1С в PostgreSQL
Что именно нужно восстановить в клиент-серверной 1С
В файловой информационной базе основной объект восстановления — файл базы.
В клиент-серверной архитектуре цепочка сложнее.
Упрощенно:
клиенты 1С
    │
    ▼
сервер 1С
    │
    ▼
PostgreSQL
    │
    ├─ данные БД
    ├─ WAL
    └─ конфигурация СУБД
Но рабочий контур может включать и другие компоненты:
- кластер серверов 1С;
- учетную запись подключения к PostgreSQL;
- внешние обработки;
- файловые каталоги;
- обмены;
- сертификаты;
- фоновые и регламентные задания;
- интеграции с внешними системами;
- настройки публикации;
- параметры подключения пользователей.
Поэтому результат:
PostgreSQL запущенеще не означает:
1С восстановленаПосле recovery нужно проверять весь прикладной контур.
Full backup, WAL и PITR: чем они отличаются
Для восстановления PostgreSQL важно различать полную резервную копию и журнал изменений.
Полный backup
Полный backup фиксирует состояние данных, на основе которого можно развернуть PostgreSQL.
Условно:
02:00 — создан полный backupЕсли восстановить только его, база вернется примерно к состоянию этой точки.
Все изменения после нее без дополнительных журналов будут потеряны.
WAL
WAL — Write-Ahead Log, журнал предзаписи PostgreSQL.
До изменения страниц данных PostgreSQL сначала фиксирует необходимую информацию в WAL.
За счет этого журнал используется для:
- восстановления после аварийного завершения;
- репликации;
- архивирования изменений;
- Point-in-Time Recovery.
Если WAL архивируется отдельно от основной базы, изменения после полного backup можно последовательно воспроизвести.
Например:
02:00 — полный backup
02:10 — WAL
02:20 — WAL
02:30 — WAL
...
11:45 — ошибочно удалены данные
11:46 — WAL
Если вся нужная цепочка WAL сохранена, сервер можно восстановить не только на 02:00, но и на момент непосредственно перед ошибкой.
PITR
PITR — Point-in-Time Recovery, восстановление к выбранной точке времени.
Например:
11:44:59Вместо потери почти десяти часов данных можно попытаться остановить воспроизведение WAL непосредственно перед нежелательной операцией.
Почему для 1С одного ежедневного backup может быть недостаточно
Предположим, база 1С резервируется один раз ночью.
02:00 — backup
09:00 — начало рабочего дня
16:30 — ошибка в базе
Если восстановиться только из полной копии 02:00, потенциальная потеря данных составит большую часть рабочего дня.
Для небольшой тестовой базы это может быть допустимо.
Для рабочей 1С с документами, заказами, проведениями и обменами — часто нет.
Поэтому до настройки backup нужно определить два показателя.
RPO
Например:
RPO = 15 минутозначает, что после аварии бизнес готов потерять не более примерно 15 минут изменений.
RTO
Например:
RTO = 2 часаозначает, что информационная база должна вернуться в работу в течение двух часов после инцидента.
Если требования такие:
RPO = 15 минут
RTO = 2 часа
один ночной backup явно не закрывает задачу.
Нужна схема, которая учитывает более частые точки восстановления или архивирование WAL.
Какой backup можно считать пригодным к восстановлению
Факт наличия файла резервной копии — только первый уровень проверки.
Для recovery нужно понимать:
- когда создан backup;
- завершился ли процесс без ошибок;
- где физически хранится копия;
- можно ли прочитать файлы;
- есть ли нужная цепочка WAL;
- соответствует ли backup версии PostgreSQL;
- достаточно ли прав для восстановления;
- можно ли реально развернуть копию на тестовом сервере.
Даже если задание каждый день пишет:
backup completed successfullyэто еще не проверяет:
- повреждение архива;
- отсутствие части WAL;
- ошибку конфигурации;
- недостающие права;
- несовместимость версии;
- отсутствие документации по восстановлению.
Поэтому у критичной 1С нужен не только backup-job, но и периодический тест restore.
Что нужно подготовить до аварии
План восстановления должен существовать до того, как база перестала работать.
Минимально нужно знать:
- где находится последний полный backup;
- где хранятся WAL;
- сколько времени они хранятся;
- кто имеет к ним доступ;
- зашифрованы ли копии;
- сколько точек восстановления доступно;
- какой RPO принят;
- какой RTO принят;
- какая версия PostgreSQL используется;
- какая версия платформы 1С работает с базой;
- где можно безопасно развернуть тестовое восстановление;
- кто принимает решение о возврате пользователей.
Упрощенный recovery-runbook:
зафиксировать инцидент
        ↓
выбрать точку
        ↓
развернуть копию
        ↓
восстановить PostgreSQL
        ↓
проверить БД
        ↓
подключить 1С
        ↓
проверить приложение
        ↓
вернуть пользователей
Если этот порядок впервые составляется уже во время аварии, RTO почти наверняка увеличивается.
Сценарии восстановления: полный backup и PITR
Сценарий 1. Восстановление 1С из полного backup PostgreSQL
Полный backup подходит, если:
- достаточно вернуть базу к моменту создания копии;
- более свежих WAL нет;
- потеря данных после backup допустима;
- нужно восстановиться после серьезного сбоя диска или сервера;
- требуется развернуть отдельную копию базы для проверки.
Безопаснее по возможности не восстанавливать сразу поверх единственного production-экземпляра.
Шаг 1. Останавливаем пользовательский доступ
Если исходная база еще частично работает, но принято решение о recovery, нужно прекратить новые изменения.
Иначе ситуация будет выглядеть так:
администратор готовит restore
        +
пользователи продолжают работать
        =
появляются новые данные
которые потом могут быть потеряны.
Нужно остановить доступ пользователей и фоновые операции в соответствии с архитектурой 1С.
Шаг 2. Фиксируем время инцидента
Запишите:
- когда проблема была замечена;
- когда, предположительно, она началась;
- что происходило непосредственно перед ней;
- какие пользователи и задания могли изменить данные.
Это особенно важно, если позже потребуется PITR.
Шаг 3. Выбираем заведомо рабочую копию
Не обязательно выбирать самый свежий backup.
Например:
01:00 — backup A
08:00 — установлено проблемное изменение
10:00 — backup B
11:00 — обнаружена ошибка
Backup B новее, но уже может содержать проблему.
Поэтому нужна последняя заведомо корректная точка, а не просто последняя по времени.
Шаг 4. Разворачиваем PostgreSQL в изолированной среде
Если инфраструктура позволяет, сначала лучше восстановить базу на отдельном сервере или тестовом экземпляре.
Это дает возможность:
- проверить backup;
- посмотреть данные;
- убедиться в корректности версии PostgreSQL;
- проверить подключение 1С;
- не разрушать единственный production-сервер.
Шаг 5. Восстанавливаем полный backup
Конкретная команда зависит от того, чем создавалась копия:
- физическим backup;
- pgBackRest;
- Barman;
- WAL-G;
- другим инструментом;
- средствами платформы или провайдера.
Поэтому универсальной одной команды для всех случаев здесь нет.
Важно соблюдать документацию именно используемого метода backup.
Шаг 6. Проверяем PostgreSQL
После старта не нужно сразу подключать всех пользователей.
Сначала проверяем СУБД.
Например, подключаемся через psql и выполняем:
SELECT now();Проверяем, не находится ли сервер в recovery:
SELECT pg_is_in_recovery();После завершенного обычного восстановления ожидается:
falseТакже можно посмотреть размер текущей базы:
SELECT pg_size_pretty(pg_database_size(current_database()));Размер должен быть реалистичным относительно исходной информационной базы.
Сценарий 2. Восстановление 1С по WAL до точки во времени
Если настроено архивирование WAL, можно восстановить базу ближе к моменту инцидента.
Предположим:
10:00 — полный backup
14:17 — ошибочно удалены документы
14:18 — проблему заметили
Если доступна нужная цепочка WAL, логичная цель:
14:16:59Схема:
полный backup
      ↓
подключить архив WAL
      ↓
replay WAL
      ↓
дойти до target
      ↓
остановить recovery
      ↓
запустить восстановленную БД
Почему важно знать версию PostgreSQL
Настройка recovery в PostgreSQL менялась между версиями.
В современных версиях используются параметры recovery и файл recovery.signal, тогда как старые инструкции могут ссылаться на механизмы, характерные для устаревших релизов.
Поэтому нельзя копировать recovery-конфигурацию из случайной старой статьи без проверки версии PostgreSQL.
Общая логика остается такой:
restore_command
+
recovery target
+
recovery.signal
но конкретный синтаксис нужно сверять с документацией именно вашей версии PostgreSQL.
Как выбрать правильную точку восстановления
Одна из самых сложных задач PITR — определить, когда именно началась проблема.
Момент обнаружения и момент повреждения данных могут сильно отличаться.
Например:
14:10 — старт ошибочного обмена
14:12 — начали изменяться данные
14:17 — пользователи заметили проблему
14:18 — администратору сообщили
Если восстановиться на:
14:16:59данные уже могут быть повреждены.
Правильная точка должна быть до начала нежелательной операции.
Где искать время начала инцидента
Помочь могут:
- журнал регистрации 1С;
- журналы PostgreSQL;
- логи интеграции;
- журнал обмена;
- application logs;
- cron;
- systemd timers;
- регламентные задания;
- история действий администратора.
Нужно искать первое событие, которое запустило неправильное изменение.
ошибка замечена
      ↓
определяем симптом
      ↓
ищем первое изменение
      ↓
выбираем target до него
Проверка PostgreSQL и 1С после восстановления
Что проверить в PostgreSQL после recovery
После восстановления сначала проверяем техническое состояние СУБД.
PostgreSQL запускается без recovery loop
Проверяем статус службы.
Например:
sudo systemctl status postgresqlЕсли используется конкретный instance или другая схема запуска, имя unit может отличаться.
База доступна
Подключаемся:
psql -d DATABASE_NAMEПроверяем:
SELECT now();Recovery завершен
SELECT pg_is_in_recovery();Для уже открытого рабочего экземпляра ожидаем:
falseЕсли остается:
trueнужно понять, почему сервер все еще находится в recovery.
Проверяем размер базы
SELECT pg_size_pretty(pg_database_size(current_database()));Если рабочая база обычно занимает сотни гигабайтов, а восстановленная неожиданно показывает несколько мегабайт, это очевидный повод не подключать 1С дальше.
Проверяем расширения
Если приложение зависит от PostgreSQL extensions:
SELECT extname, extversion
FROM pg_extension
ORDER BY extname;
После recovery они должны соответствовать ожидаемой среде.
Проверяем критичные ошибки
Нужно посмотреть PostgreSQL logs после первого запуска и убедиться, что нет повторяющихся ошибок:
- повреждения страниц;
- отсутствующих WAL;
- проблем с каталогом данных;
- ошибок расширений;
- проблем прав.
Что проверить именно в 1С после восстановления
После технической проверки PostgreSQL можно переходить к прикладному уровню.
Сервер 1С видит информационную базу
Проверяем:
- доступность сервера PostgreSQL;
- имя базы;
- учетную запись СУБД;
- пароль;
- сетевые настройки;
- права.
Если база восстановлена на другой сервер, параметры подключения могут отличаться от production.
Информационная база открывается
Сначала лучше использовать ограниченный тестовый доступ.
Не возвращайте сразу десятки пользователей.
Проверяем запуск 1С и вход в информационную базу.
Открываются основные данные
Например:
- ключевые справочники;
- документы;
- остатки;
- регистры, которые используются в рабочих сценариях;
- актуальные данные на выбранный момент recovery.
Особенно важно проверить документы непосредственно перед точкой восстановления.
Например, если target:
14:09:59нужно убедиться, что операции до 14:09 присутствуют, а ошибочные изменения после 14:10 отсутствуют.
Проверяем безопасную операцию записи
После read-only проверки можно выполнить контролируемое тестовое действие, если это допустимо.
Например:
- создать тестовый объект;
- выполнить разрешенную операцию;
- записать и прочитать данные.
Но делать это нужно только после того, как принято решение, что именно эта восстановленная база рассматривается как будущий production.
Проверяем фоновые задания
Очень важный этап.
После запуска могут автоматически стартовать:
- обмены;
- регламентные задания;
- загрузки;
- выгрузки;
- синхронизации;
- отправка сообщений;
- интеграции.
Если восстановлена база на прошлый момент, автоматический запуск внешнего обмена может сразу изменить данные.
Как проверять целостность базы 1С после recovery
Термин «целостность» здесь важно использовать аккуратно.
Есть несколько уровней.
Физическая целостность PostgreSQL
Это корректность структуры хранения PostgreSQL и возможность нормально читать данные.
Она относится к уровню СУБД.
Логическая целостность данных
Например:
- записи связаны ожидаемым образом;
- нет очевидно потерянных наборов данных;
- бизнес-объекты соответствуют выбранной точке.
Прикладная целостность 1С
Это уже уровень платформы и конфигурации.
Можно использовать штатные механизмы диагностики 1С, но запуск исправляющих операций требует особой осторожности.
Если база открывается и бизнес-сценарии работают, сначала стоит зафиксировать восстановленное состояние.
И только затем решать, нужны ли дополнительные исправляющие процедуры.
Почему нельзя проверять восстановление только техническим тестом
Набор:
PostgreSQL = active
pg_is_in_recovery() = false
SELECT = работает
не проверяет бизнес-состояние 1С.
Можно получить технически исправную БД, в которой:
- отсутствуют нужные документы;
- восстановлена неправильная точка;
- уже произошел ошибочный обмен;
- не работают фоновые задания;
- не совпадает конфигурация;
- нарушены интеграции.
Поэтому итоговая проверка должна выглядеть так:
PostgreSQL
    ↓
сервер 1С
    ↓
информационная база
    ↓
ключевые данные
    ↓
бизнес-операция
    ↓
фоновые задания
    ↓
интеграции
Возврат пользователей и работа с данными после recovery
Что делать с пользователями после восстановления
Пользователей лучше возвращать поэтапно.
Шаг 1. Техническая проверка
Проверяем PostgreSQL, сервер 1С, сеть, права и журналы.
Шаг 2. Прикладная проверка
Проверяем:
- вход;
- документы;
- справочники;
- отчеты;
- чтение данных;
- тестовую операцию.
Шаг 3. Проверяем фоновые процессы
Не должны неожиданно стартовать нежелательные обмены или регламентные задания.
Шаг 4. Ограниченный пользовательский тест
Даем доступ небольшому числу ответственных пользователей и проверяем их реальные сценарии.
Шаг 5. Возвращаем основную нагрузку
После подтверждения можно возвращать остальных пользователей.
Шаг 6. Наблюдаем систему
После открытия доступа контролируем:
- PostgreSQL logs;
- журнал регистрации 1С;
- ошибки;
- load;
- CPU;
- RAM;
- диск;
- фоновые задания.
Шаг 7. Создаем новую контрольную точку
После того как система стабилизирована и признана рабочей, полезно создать свежую резервную копию.
Она станет новой подтвержденной точкой после инцидента.
Что делать с данными между точкой восстановления и моментом сбоя
PITR возвращает базу к выбранному моменту.
Все изменения после него отсутствуют.
Например:
14:10 — target recovery
14:10–14:30 — были корректные документы
14:31 — произошла ошибка
Если восстановиться на 14:09:59, вместе с ошибочным изменением будут потеряны и корректные операции 14:10–14:30.
Возникает отдельная задача: можно ли вернуть часть этих данных вручную или через повторный ввод.
Это зависит от конкретной конфигурации 1С.
Важно не пытаться механически объединять две базы.
рабочая база до аварии
        +
восстановленная база
        =
автоматически объединить
Для 1С это не является универсальным безопасным сценарием.
Иногда корректные документы можно:
- повторно ввести;
- загрузить из внешней системы;
- повторить обмен;
- восстановить прикладными средствами.
Но такой план нужно разрабатывать отдельно для конкретной конфигурации.
Что проверить после инцидента и какие ошибки не допускать
Проверяем цепочку резервного копирования после инцидента
Recovery не заканчивается возвратом пользователей.
Нужно понять, почему резервное копирование сработало именно так и соответствует ли оно требованиям бизнеса.
Проверяем:
- когда теперь выполняется full backup;
- архивируются ли WAL;
- нет ли пробелов в WAL;
- хватает ли retention;
- достаточно ли RPO;
- соответствует ли RTO;
- выполняется ли тест restore;
- есть ли отдельное хранение копий.
Если инцидент показал, что:
RPO бизнеса = 15 минута реальная схема позволяет восстановиться только к прошлой ночи, backup-политика должна быть изменена.
Типичные ошибки при восстановлении 1С в PostgreSQL
Есть только полный backup, хотя бизнес требует низкий RPO
Одна ночная копия не позволяет вернуть состояние базы на середину рабочего дня.
Если потеря нескольких часов данных недопустима, нужно продумывать WAL/PITR или более частую схему резервирования.
Backup никогда не тестировали восстановлением
Задание много месяцев завершалось успешно, но во время аварии выясняется, что архив поврежден или процедура restore неизвестна.
Тестовое восстановление должно быть частью backup-процесса.
Выбирают точку по времени обнаружения проблемы
Если ошибка началась раньше, восстановленная база уже будет содержать нежелательные изменения.
Нужно искать начало события.
Восстанавливают сразу поверх production
Так теряется возможность сравнить состояние, сохранить текущие данные и безопасно проверить backup.
Если возможно, сначала используйте изолированную среду.
Сразу возвращают всех пользователей
PostgreSQL запустился, поэтому база объявляется рабочей.
Но не проверены:
- прикладные данные;
- фоновые задания;
- интеграции;
- права;
- реальный пользовательский сценарий.
Забывают отключить регламентные задания
После recovery система сама повторяет обмен или обработку, которая привела к проблеме.
Считают pg_is_in_recovery() полной проверкой
Результат:
falseозначает только, что экземпляр PostgreSQL не находится в recovery.
Это не проверка информационной базы 1С.
Не учитывают версию PostgreSQL
Используют инструкцию по PITR для другой версии СУБД и получают проблемы с recovery-конфигурацией.
Не фиксируют ход восстановления
После успешного инцидента никто не записал:
- какую точку выбрали;
- почему;
- какой backup использовали;
- какие WAL понадобились;
- сколько занял restore;
- что проверяли.
В следующий раз команда начинает процедуру заново.
Заключение
Надежное восстановление 1С в PostgreSQL начинается не в момент сбоя, а при проектировании резервного копирования.
Полный backup дает базовую точку, а архивирование WAL позволяет при необходимости приблизить восстановление к моменту инцидента и уменьшить потерю данных.
Но даже технически успешный restore PostgreSQL — только половина работы.
После восстановления нужно проверить сервер 1С, саму информационную базу, ключевые документы, фоновые задания, интеграции и реальные пользовательские операции.
Особенно важно правильно выбрать target для PITR: момент обнаружения проблемы может быть значительно позже момента, когда данные начали изменяться неправильно.
Recovery считается завершенным только тогда, когда не просто работает PostgreSQL, а подтверждено корректное состояние всей системы 1С и снова работает резервное копирование.
Что почитать дальше
Для эксплуатации клиент-серверной 1С полезно также разобраться со смежными уровнями:
- PostgreSQL для 1С: установка, настройка и параметры производительности — подготовка СУБД под рабочую базу 1С.
- Развертывание серверной инфраструктуры 1С — архитектура сервера 1С, СУБД, сетевого доступа и рабочих компонентов.
- Установка сервера 1С на Windows Server — практический порядок подготовки серверной части платформы.
- Как создать клиент-серверную базу 1С в SQL Server — соседний сценарий клиент-серверной инфраструктуры 1С на Microsoft SQL Server.
Когда стоит обратиться к специалистам
Обычное восстановление из проверенного полного backup можно выполнить самостоятельно, если процедура уже отработана и допустим возврат к конкретной сохраненной точке.
Риск значительно выше, если нужно выполнить PITR, нет уверенности в полноте WAL, непонятен момент начала повреждающей операции или восстановленная база должна быть согласована с обменами и другими системами.
Если 1С работает в клиент-серверном режиме, IPWAY может помочь с серверной инфраструктурой, настройкой резервного копирования и сопровождением восстановления после сбоя. Здесь важен не только сам backup, но и проверенная процедура, которая позволяет вернуть PostgreSQL и 1С к рабочему состоянию с понятной потерей данных и временем простоя.
Кратко
- Полный backup PostgreSQL возвращает базу к конкретной сохраненной точке, а WAL позволяет выполнить более точное восстановление во времени.
- PITR имеет смысл только при полной и проверенной цепочке архивирования WAL.
- RPO определяет допустимую потерю данных, а RTO — допустимое время восстановления.
- Выбирать точку recovery нужно до начала ошибочной операции, а не просто до момента ее обнаружения.
- После restore недостаточно проверить, что PostgreSQL запустился: нужно отдельно проверить сервер 1С, информационную базу, данные и фоновые задания.
pg_is_in_recovery() = falseне является проверкой целостности 1С.- Резервная копия считается надежной только после реального тестового восстановления.
- После успешного recovery нужно снова проверить backup-процесс и создать новую подтвержденную точку восстановления.

Представьте ситуацию: бухгалтерия небольшой компании работает в 1С, все документы и отчёты хранятся в одной информационной базе. Каждый день сотрудники проводят платежи, оформляют счета, рассчитывают зарплату…

Представьте, что в компании перестала работать 1С. Сотрудники не могут открыть бухгалтерию, оформить документы, посмотреть остатки товаров или получить информацию о заказах. Если проблема связана с…

Перенос 1С на арендованный сервер — это не просто копирование информационной базы с одного компьютера на другой. Чтобы сотрудники могли продолжить работу, необходимо подготовить серверную среду,…

В клиент-серверной 1С сервер приложений и система управления базами данных (СУБД) могут работать на одной виртуальной машине. Для многих компаний это вполне разумная архитектура: её проще…
Новая база 1С может быстро открыться у администратора и при этом начать заметно тормозить, когда к ней одновременно подключатся сотрудники. Проверка одного сеанса не показывает, как…
SQL Server для 1С может месяцами работать без заметных проблем, а затем начать постепенно замедляться. Отчёты выполняются дольше, закрытие периода создаёт повышенную нагрузку, журнал транзакций занимает…