

Обслуживание SQL Server для 1С: статистика, индексы, tempdb и контроль журнала
SQL Server для 1С может месяцами работать без заметных проблем, а затем начать постепенно замедляться. Отчёты выполняются дольше, закрытие периода создаёт повышенную нагрузку, журнал транзакций занимает всё больше места, а tempdb неожиданно разрастается.
Причина не всегда заключается в недостатке процессора или оперативной памяти. На работу базы влияют актуальность статистики, состояние индексов, свободное место, модель восстановления, резервные копии журнала и корректность регламентных заданий.
При этом обслуживание SQL Server нельзя свести к универсальному скрипту, который каждую ночь перестраивает все индексы, обновляет всю статистику и уменьшает файлы. Такие действия способны создать блокировки, увеличить журнал транзакций, занять оставшееся место на диске и ухудшить работу пользователей.
В этой статье рассматриваем уже работающий SQL Server для 1С. Первичную конфигурацию памяти, MaxDOP, файлов базы и tempdb мы разбирали отдельно в материале «Как настроить SQL Server для 1С». Здесь сосредоточимся на повторяемом регламенте: что проверять, какие операции выполнять по показаниям и как контролировать результат.
Что должно входить в регламент обслуживания SQL Server для 1С
Обслуживание начинается не с запуска команд, а с понимания текущего состояния системы. Администратор должен знать, где расположены файлы базы, как настроены резервные копии, какая модель восстановления используется и сколько места доступно на дисках.
Чем обслуживание отличается от первичной настройки
Первичная настройка определяет базовую конфигурацию экземпляра:
- ограничения памяти SQL Server;
- параметры параллелизма;
- расположение файлов данных и журнала;
- начальный размер файлов;
- количество и размеры файлов
tempdb; - модель восстановления;
- параметры автоматического роста.
Регулярное обслуживание отвечает на другие вопросы:
- завершаются ли резервные копии;
- остаётся ли база физически и логически целостной;
- актуальна ли статистика;
- связана ли фрагментация индексов с ухудшением запросов;
- почему растёт журнал;
- что занимает
tempdb; - достаточно ли места до следующего окна обслуживания;
- завершились ли задания без ошибок.
Изменение конфигурации и обслуживание связаны, но не должны смешиваться в одном автоматическом сценарии.
Что зафиксировать до автоматизации
Создайте эксплуатационную карточку SQL Server:
| Параметр | Что зафиксировать |
|---|---|
| База 1С | Имя базы и её назначение |
| Версия SQL Server | Версия и редакция |
| Модель восстановления | Simple, Full или Bulk-logged |
| Файлы данных | Пути, размеры и параметры роста |
| Журнал транзакций | Путь, размер и параметры роста |
| tempdb | Количество файлов, размеры и дисковое размещение |
| Резервные копии | Типы, расписание и срок хранения |
| Окно обслуживания | Период минимальной пользовательской нагрузки |
| Ответственный | Кто получает и проверяет уведомления |
| Допустимый простой | Какие операции разрешены в рабочее время |
Получить базовые сведения о базе можно запросом:
SELECT
    name,
    state_desc,
    recovery_model_desc,
    user_access_desc,
    log_reuse_wait_desc
FROM sys.databases
WHERE name = N'ИмяБазы';
Замените ИмяБазы фактическим именем информационной базы 1С.
Параметр log_reuse_wait_desc пригодится при диагностике журнала: он показывает, какое условие в данный момент мешает повторно использовать его пространство.
С чего начать обслуживание
Базовая последовательность выглядит так:
- Проверить состояние базы и резервных копий.
- Проверить свободное место.
- Убедиться, что предыдущие задания завершились успешно.
- Выполнить запланированную проверку целостности.
- Оценить статистику и индексы.
- Проверить
tempdb. - Проверить журнал транзакций.
- Зафиксировать длительность и результат.
- Настроить оповещение об ошибках.
Нельзя начинать ресурсоёмкое обслуживание, если на диске почти не осталось места или отсутствует актуальная резервная копия.
Пример базового расписания
Частота зависит от нагрузки, размера базы и требований бизнеса. Таблица ниже — начальная модель, а не универсальный график.
| Проверка | Примерная периодичность | Что контролировать |
|---|---|---|
| Результаты заданий | Каждый рабочий день | Ошибки, длительность, незавершённые шаги |
| Свободное место | Постоянный мониторинг | Диски данных, журнала, backup и tempdb |
| Резервные копии | Согласно RPO | Наличие, возраст и возможность восстановления |
| Использование журнала | Регулярно и при росте | Занятое пространство и причина удержания |
| tempdb | Регулярно и при проблемах | Рост файлов и распределение пространства |
| Статистика и индексы | По показаниям | Связь с медленными запросами |
| CHECKDB | По утверждённому графику | Целостность и успешное завершение |
| Тест восстановления | Периодически | Фактическая работоспособность копии |
Резервные копии и проверка целостности базы
Резервное копирование и проверка целостности решают разные задачи.
Backup позволяет восстановить состояние базы, а DBCC CHECKDB помогает обнаружить нарушения физической и логической целостности. Наличие одного механизма не отменяет необходимость второго.
Почему наличия файла backup недостаточно
Файл резервной копии может существовать, но оказаться непригодным для восстановления из-за ошибки хранения, неполной цепочки копий, повреждения носителя или неверного расписания.
Минимальная проверка должна отвечать на вопросы:
- когда создана последняя полная копия;
- выполняются ли дифференциальные копии и копии журнала, если они предусмотрены;
- нет ли ошибок в заданиях backup;
- хватает ли места в хранилище;
- соответствует ли цепочка копий модели восстановления;
- выполнялось ли тестовое восстановление.
Команда RESTORE VERIFYONLY проверяет, что SQL Server может прочитать резервный набор и что он имеет ожидаемую структуру:
RESTORE VERIFYONLY
FROM DISK = N'D:\Backup\ИмяБазы_full.bak';
Путь необходимо заменить фактическим.
Надёжная проверка — восстановить копию в отдельную среду, выполнить технические проверки и открыть информационную базу предусмотренным способом.
Что проверяет DBCC CHECKDB
DBCC CHECKDB проверяет распределение страниц, таблицы, индексы, каталог и другие структуры базы.
Базовый запуск:
DBCC CHECKDB (N'ИмяБазы')
WITH NO_INFOMSGS, ALL_ERRORMSGS;
Если ошибок нет, команда завершится без сообщений о нарушении целостности.
Для крупной базы перед выполнением можно оценить необходимое пространство:
DBCC CHECKDB (N'ИмяБазы')
WITH ESTIMATEONLY;
Проверка использует ресурсы процессора, дисковой подсистемы и tempdb. Её продолжительность зависит от размера базы, скорости хранения и текущей нагрузки.
Полная и сокращённая проверка
Для частой проверки крупной производственной базы можно рассматривать вариант:
DBCC CHECKDB (N'ИмяБазы')
WITH PHYSICAL_ONLY, NO_INFOMSGS;
PHYSICAL_ONLY сокращает объём работы и помогает обнаруживать физические повреждения страниц, ошибки контрольных сумм и проблемы распределения. Но он пропускает часть логических проверок.
Поэтому сокращённый запуск не заменяет периодический полный DBCC CHECKDB. Соотношение между ними определяется требованиями к системе, размером базы и доступным окном обслуживания.
Можно ли проверять восстановленную копию
Если полная проверка слишком тяжела для production, один из вариантов — восстановить свежую резервную копию на отдельном SQL Server и выполнить DBCC CHECKDB там.
Такой подход одновременно проверяет:
- читаемость резервной копии;
- возможность восстановления;
- целостность восстановленной базы.
Но он не полностью заменяет контроль production-хранилища. Повреждение, возникшее после создания backup или связанное с конкретным диском рабочего сервера, может не попасть в проверяемую копию.
Что делать при обнаружении ошибок
Если DBCC CHECKDB сообщает о повреждении:
- Сохраните полный вывод команды.
- Не запускайте исправление автоматически.
- Проверьте состояние дисков, журнал Windows и SQL Server Error Log.
- Определите последнюю заведомо исправную резервную копию.
- Остановите операции, способные увеличить повреждение.
- Подготовьте восстановление в отдельную среду.
- Согласуйте дальнейшие действия с владельцем системы.
Не следует воспринимать REPAIR_ALLOW_DATA_LOSS как обычную команду исправления. Она действительно может удалить повреждённые страницы и привести базу к физически согласованному состоянию ценой потери данных.
Статистика и индексы: что обслуживать и когда
Оптимизатор SQL Server использует статистику, чтобы оценивать количество строк и выбирать план выполнения запроса. Если оценки значительно расходятся с фактическими данными, SQL Server может выбрать более дорогой план.
Индексы помогают находить строки без полного чтения таблицы. Но обслуживание каждого индекса по расписанию не гарантирует ускорения.
Сначала проверьте автоматические настройки
Для базы обычно должны быть осознанно настроены автоматическое создание и обновление статистики.
Проверить параметры:
SELECT
    name,
    is_auto_create_stats_on,
    is_auto_update_stats_on,
    is_auto_update_stats_async_on
FROM sys.databases
WHERE name = N'ИмяБазы';
Если автоматическое обновление включено, это не означает, что статистику никогда не нужно обновлять вручную. Но и регулярный полный пересчёт всех объектов без анализа тоже не нужен.
Почему нельзя обновлять статистику постоянно
Обновление статистики может приводить к перекомпиляции планов запросов. Кроме того, построение статистики расходует CPU, выполняет чтение данных и может использовать tempdb.
Для конкретной таблицы статистику можно обновить так:
UPDATE STATISTICS dbo.ИмяТаблицы;Для конкретного объекта статистики:
UPDATE STATISTICS dbo.ИмяТаблицы ИмяСтатистики;Перед выполнением замените имена фактическими и убедитесь, что операция нужна.
Для всей базы существует процедура:
EXEC sys.sp_updatestats;Она удобна как инструмент, но не должна автоматически запускаться в любое окно без оценки продолжительности и влияния. На крупной базе 1С обновление большого количества статистик может создать заметную нагрузку.
Как оценивать состояние индексов
Для первичной оценки можно использовать динамическое представление sys.dm_db_index_physical_stats.
Пример запроса в контексте нужной базы:
SELECT
    OBJECT_SCHEMA_NAME(ips.object_id) AS schema_name,
    OBJECT_NAME(ips.object_id) AS table_name,
    i.name AS index_name,
    ips.page_count,
    ips.avg_fragmentation_in_percent,
    ips.avg_page_space_used_in_percent
FROM sys.dm_db_index_physical_stats
(
    DB_ID(),
    NULL,
    NULL,
    NULL,
    'LIMITED'
) AS ips
JOIN sys.indexes AS i
    ON i.object_id = ips.object_id
   AND i.index_id = ips.index_id
WHERE
    ips.index_id > 0
    AND ips.page_count > 0
ORDER BY ips.page_count DESC;
Режим LIMITED уменьшает объём сканирования, но на большой базе запрос всё равно может создать дополнительную нагрузку.
При анализе учитывайте:
- размер индекса;
- количество страниц;
- плотность страниц;
- характер запросов;
- частоту изменений данных;
- длительность операции;
- доступное место;
- влияние на журнал;
- фактические жалобы пользователей.
Высокий процент фрагментации маленького индекса редко является приоритетной проблемой. И наоборот, крупный индекс, который активно используется тяжёлыми запросами, требует внимательного анализа.
REORGANIZE или REBUILD
REORGANIZE постепенно упорядочивает листовой уровень существующего индекса. Операция обычно менее ресурсоёмкая и может продолжаться после прерывания с уже достигнутого состояния.
Пример:
ALTER INDEX [ИмяИндекса]
ON [dbo].[ИмяТаблицы]
REORGANIZE;
REBUILD заново создаёт структуру индекса:
ALTER INDEX [ИмяИндекса]
ON [dbo].[ИмяТаблицы]
REBUILD;
Перед REBUILD необходимо оценить:
- доступное место;
- размер индекса;
- рост журнала транзакций;
- возможные блокировки;
- поддержку online-операции используемой редакцией;
- допустимую нагрузку;
- время до начала рабочего дня.
Почему универсального процента недостаточно
Популярная схема с фиксированными порогами фрагментации удобна, но не учитывает размер объектов, плотность страниц и фактическое влияние на запросы.
Практичнее действовать так:
- Найти запросы, производительность которых ухудшилась.
- Определить используемые ими таблицы и индексы.
- Сопоставить фрагментацию и плотность страниц с периодами ухудшения.
- Проверить, помогает ли обновление статистики.
- Только затем выбирать
REORGANIZEилиREBUILD. - Сравнить показатели после обслуживания.
Если обновление статистики даёт тот же эффект, что перестроение индекса, выполнять регулярный REBUILD может быть не нужно.
Особенности базы 1С
Не создавайте и не удаляйте индексы в рабочей базе 1С только на основании общего совета из Интернета. Изменения схемы необходимо проверять с учётом версии платформы, конфигурации, расширений и требований сопровождения.
Регламентное обслуживание существующих индексов и проектирование новых индексов — разные задачи. Второе требует анализа конкретных запросов и тестирования.
Как контролировать tempdb
tempdb — системная база SQL Server для временных объектов и внутренних операций. Её используют сортировки, хеширование, временные таблицы, версионность строк, обслуживание индексов и другие процессы.
Проблема проявляется не только как большой файл. Важно понять, кто занимает пространство и является ли рост разовым или повторяющимся.
Проверяем файлы tempdb
Выполните запрос в контексте tempdb:
USE tempdb;
GO

SELECT
    name,
    type_desc,
    size * 8.0 / 1024 AS size_mb,
    max_size,
    growth,
    is_percent_growth,
    physical_name
FROM sys.database_files;
Проверьте:
- одинаковы ли размеры файлов данных;
- одинаковы ли параметры роста;
- где физически расположены файлы;
- хватает ли места на диске;
- не задан ли слишком маленький шаг автоприроста;
- не растёт ли один файл заметно быстрее остальных.
Значение поля growth интерпретируется по-разному в зависимости от is_percent_growth, поэтому его нельзя считать мегабайтами без пересчёта.
Что занимает пространство
Общее распределение пространства можно посмотреть через sys.dm_db_file_space_usage:
USE tempdb;
GO

SELECT
    SUM(user_object_reserved_page_count) * 8.0 / 1024
        AS user_objects_mb,
    SUM(internal_object_reserved_page_count) * 8.0 / 1024
        AS internal_objects_mb,
    SUM(version_store_reserved_page_count) * 8.0 / 1024
        AS version_store_mb,
    SUM(unallocated_extent_page_count) * 8.0 / 1024
        AS free_space_mb
FROM sys.dm_db_file_space_usage;
Результат помогает определить направление диагностики:
| Что растёт | Возможная область поиска |
|---|---|
| User objects | Временные таблицы и табличные переменные |
| Internal objects | Сортировки, хеширование и служебные операции |
| Version store | Длительные транзакции и версионность строк |
| Файлы при свободном месте внутри | Ранее выполненная пиковая операция |
Один снимок не показывает динамику. Полезнее собирать показатели регулярно и сопоставлять их с заданиями 1С, отчётами, обменами и обслуживанием SQL Server.
Почему перезапуск не устраняет причину
При перезапуске экземпляра tempdb создаётся заново с настроенными начальными размерами. Файлы могут уменьшиться, но причина роста останется.
После следующего тяжёлого отчёта, перестроения индекса или проблемной транзакции база снова займёт необходимое ей пространство.
Перезапуск SQL Server ради уменьшения tempdb:
- прерывает работу пользователей;
- не объясняет источник нагрузки;
- может замаскировать повторяющуюся проблему;
- не заменяет правильный размер файлов.
Когда менять количество файлов
Количество файлов tempdb зависит от версии SQL Server, числа логических процессоров и наличия конкуренции за страницы распределения.
Само по себе высокое использование tempdb не означает, что нужно добавлять файлы. Сначала определите характер ожиданий и нагрузки.
Если файлов несколько, для равномерного использования важны одинаковые:
- начальные размеры;
- шаги роста;
- условия размещения.
Изменять количество файлов следует после диагностики, а не по универсальной формуле без учёта конкретного сервера.
Журнал транзакций и свободное место на диске
Журнал транзакций хранит сведения, необходимые для обеспечения согласованности операций и восстановления базы. Рост файла не всегда означает ошибку: SQL Server может выделить пространство под реальную рабочую нагрузку, резервное копирование, длительную транзакцию или обслуживание индексов.
Важно различать:
- физический размер файла
.ldf; - занятое место внутри файла;
- свободные виртуальные файлы журнала;
- место на диске;
- причину, мешающую повторно использовать пространство.
Проверяем модель восстановления
Получить модель восстановления и причину ожидания повторного использования журнала:
SELECT
    name,
    recovery_model_desc,
    log_reuse_wait_desc
FROM sys.databases
WHERE name = N'ИмяБазы';
В модели Full журнал обычно требует регулярных резервных копий журнала. Полные резервные копии базы не заменяют их.
Если копии журнала не выполняются, log_reuse_wait_desc может показывать LOG_BACKUP, а файл продолжит расти.
Проверяем заполнение журнала
В контексте нужной базы:
USE [ИмяБазы];
GO

SELECT
    total_log_size_in_bytes / 1048576.0 AS total_log_mb,
    used_log_space_in_bytes / 1048576.0 AS used_log_mb,
    used_log_space_in_percent
FROM sys.dm_db_log_space_usage;
Запрос показывает физический размер и использование журнала.
Для просмотра сразу нескольких баз можно применять:
DBCC SQLPERF(LOGSPACE);Высокий процент использования — повод искать причину. Низкий процент при большом физическом файле может означать, что журнал вырос во время прежней пиковой операции и сейчас содержит свободное пространство.
Что может удерживать журнал
Поле log_reuse_wait_desc может указывать, например:
| Значение | Что проверять |
|---|---|
NOTHING | Явного ожидания нет |
LOG_BACKUP | Расписание и ошибки backup журнала |
ACTIVE_TRANSACTION | Длительную или зависшую транзакцию |
ACTIVE_BACKUP_OR_RESTORE | Выполняющуюся операцию backup или restore |
REPLICATION | Состояние репликации |
AVAILABILITY_REPLICA | Состояние реплики доступности |
CHECKPOINT | Выполнение контрольной точки |
При ACTIVE_TRANSACTION можно выполнить:
DBCC OPENTRAN (N'ИмяБазы');Команда помогает найти старейшую активную транзакцию, но не объясняет всю прикладную причину. Перед завершением процесса или сеанса нужно понять, какую операцию он выполняет и какие последствия вызовет принудительное прекращение.
Почему SHRINK не должен быть регулярным заданием
DBCC SHRINKFILE уменьшает физический файл, возвращая неиспользуемое пространство операционной системе. Это не исправляет причину роста журнала.
Если рабочая нагрузка снова потребует то же пространство, SQL Server повторно увеличит файл. Автоприрост создаёт дополнительную нагрузку и может привести к неудачному расширению при нехватке места.
Поэтому нельзя включать shrink в ежедневное или еженедельное обслуживание.
Разовая операция может рассматриваться, если:
- журнал аномально вырос из-за исключительного события;
- причина роста уже устранена;
- внутри файла действительно есть неиспользуемое пространство;
- ожидаемая рабочая нагрузка больше не требует прежнего размера;
- определён разумный целевой размер;
- операция выполняется в согласованное окно.
Контролируем автоприрост и свободное место
Автоприрост — страховочный механизм, а не способ постоянного управления размером файла.
Проверьте настройки файлов:
SELECT
    DB_NAME(database_id) AS database_name,
    name AS logical_name,
    type_desc,
    size * 8.0 / 1024 AS size_mb,
    max_size,
    growth,
    is_percent_growth,
    physical_name
FROM sys.master_files
WHERE database_id = DB_ID(N'ИмяБазы');
Для контроля свободного места на томах:
SELECT DISTINCT
    vs.volume_mount_point,
    vs.total_bytes / 1073741824.0 AS total_gb,
    vs.available_bytes / 1073741824.0 AS available_gb
FROM sys.master_files AS mf
CROSS APPLY sys.dm_os_volume_stats
(
    mf.database_id,
    mf.file_id
) AS vs;
Для выполнения запросов могут потребоваться дополнительные права.
Оповещение должно срабатывать заранее, а не тогда, когда на диске уже не осталось места для очередного расширения журнала или tempdb.
Расписание заданий и проверка результата
Регламент приносит пользу только тогда, когда операции выполняются в правильном порядке, помещаются в доступное окно и оставляют проверяемый результат.
Какие задания нельзя запускать одновременно
Не следует без необходимости совмещать:
- полный backup и тяжёлое перестроение индексов;
DBCC CHECKDBи пиковую нагрузку пользователей;- массовое обновление статистики и закрытие периода;
- обслуживание нескольких крупных баз на одном диске;
- тяжёлые задания 1С и ресурсоёмкие операции SQL Server.
Конкретное расписание зависит от дисковой подсистемы и нагрузки. Формально разные задания могут работать параллельно, но конкурировать за CPU, память, чтение и запись.
Как построить порядок
Пример логики обслуживания:
Проверка свободного места
        │
        ▼
Проверка актуальности backup
        │
        ▼
Контроль целостности
        │
        ▼
Анализ статистики и индексов
        │
        ▼
Обслуживание выбранных объектов
        │
        ▼
Контроль журнала и tempdb
        │
        ▼
Проверка результата и уведомлениеSQL Server Agent и другие способы запуска
В редакциях, поддерживающих SQL Server Agent, регламент можно разбить на отдельные задания и шаги:
- предварительная проверка;
- резервное копирование;
DBCC CHECKDB;- анализ и обслуживание статистики;
- обслуживание выбранных индексов;
- контроль файлов;
- уведомление.
Каждый шаг должен завершаться с понятным кодом результата.
В редакциях без SQL Server Agent задания приходится запускать через внешний планировщик. В этом случае особенно важно:
- использовать отдельную служебную учётную запись;
- не хранить пароль в открытом скрипте;
- сохранять стандартный вывод и ошибки;
- проверять код завершения;
- настраивать уведомление;
- защищать файлы сценариев от изменения.
Что проверять в истории задания
Для каждого задания фиксируйте:
- дату и время запуска;
- дату и время завершения;
- продолжительность;
- успешный или ошибочный статус;
- номер завершившегося шага;
- текст ошибки;
- обработанную базу;
- изменение длительности относительно обычного значения.
Рост продолжительности сам по себе может быть ранним сигналом:
- увеличения базы;
- ухудшения дисковой производительности;
- конкуренции с другими заданиями;
- расширения файлов;
- изменения рабочей нагрузки.
Контроль после обслуживания
После завершения проверьте:
- Доступность базы.
- Подключение пользователей 1С.
- Ошибки SQL Server Error Log.
- Историю заданий.
- Размер и заполнение журнала.
- Состояние
tempdb. - Свободное место.
- Длительность ключевых операций.
- Наличие и состояние резервной копии.
- Отсутствие незавершённых тяжёлых запросов.
Не оценивайте результат только по субъективному ощущению «1С стала быстрее». Сравнивайте длительность конкретных операций, ожидания SQL Server и показатели до и после изменения.
Заключение
Регулярное обслуживание SQL Server для 1С — это не набор команд, запускаемых по календарю. Хороший регламент начинается с проверки резервных копий, свободного места и состояния предыдущих заданий, а заканчивается контролем результата.
Статистику и индексы нужно обслуживать по подтверждённой необходимости. Иногда для исправления плана запроса достаточно обновить статистику, и перестраивать индекс не требуется. Если выбран REBUILD, заранее учитывайте блокировки, свободное место и возможный рост журнала.
Рост tempdb или журнала транзакций тоже нельзя лечить одним уменьшением файла. Сначала определяют источник нагрузки или причину, мешающую повторно использовать пространство, и только затем меняют конфигурацию.
Что почитать дальше
- Как настроить SQL Server для 1С — память,
MaxDOP, файлы базы,tempdbи начальная конфигурация SQL Server. - Как создать клиент-серверную базу 1С в SQL Server — создание базы, права и проверка подключения.
- Почему 1С тормозит на сервере — диагностика сервера, СУБД, дисков и конфигурации.
- Как понять, что инфраструктуру 1С пора масштабировать — признаки того, что обслуживание уже не компенсирует нехватку ресурсов.
Когда стоит обратиться к специалистам
Небольшую некритичную базу можно обслуживать самостоятельно, если администратор понимает модель восстановления, контролирует backup и может проверить результат операций.
Специалисты IPWAY могут провести диагностику SQL Server и настроить регламент в рамках услуги «Поддержка и сопровождение 1С». Если текущая инфраструктура не справляется с рабочей нагрузкой, можно подобрать сервер для 1С с подходящими ресурсами и дисковой подсистемой.
Кратко
- Регламент обслуживания начинается с проверки backup и свободного места.
DBCC CHECKDBобнаруживает нарушения целостности, но не заменяет тестовое восстановление.- Статистику не нужно обновлять чаще, чем требует рабочая нагрузка.
- Индексы следует обслуживать по показаниям, а не только по фиксированному проценту фрагментации.
- Рост
tempdbнужно связывать с конкретными запросами и операциями. - Причину удержания журнала показывает
log_reuse_wait_desc. SHRINKне должен входить в регулярное расписание.- Результат каждого задания нужно проверять и сохранять в журнале обслуживания.
Новая база 1С может быстро открыться у администратора и при этом начать заметно тормозить, когда к ней одновременно подключатся сотрудники. Проверка одного сеанса не показывает, как…
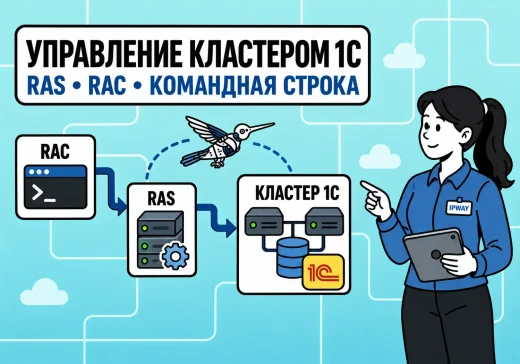
Консоль администрирования серверов 1С удобна для повседневной работы, но подходит не для всех задач. На сервере может не оказаться графического интерфейса, версии консоли и кластера могут…
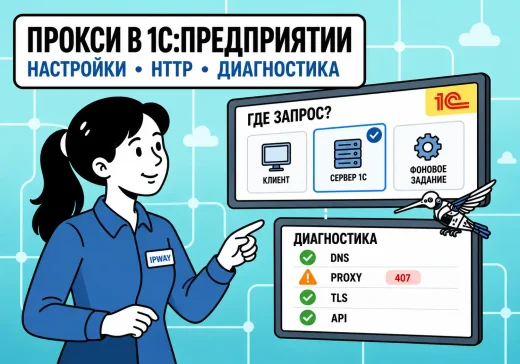
Сайты и API открываются в браузере, но 1С не может отправить отчёт, получить обновление или обратиться к внешнему сервису. В корпоративной сети с прокси-сервером это типичная…
Когда конфигурацию 1С дорабатывает один специалист, изменения еще можно контролировать вручную. Но как только над одной системой начинают работать несколько разработчиков, появляются типичные проблемы: один человек…
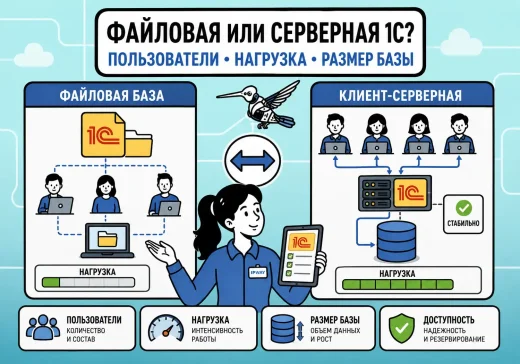
При развертывании 1С один из первых архитектурных вопросов — использовать файловую информационную базу или клиент-серверный вариант с сервером 1С и СУБД. Универсального ответа здесь нет: более…
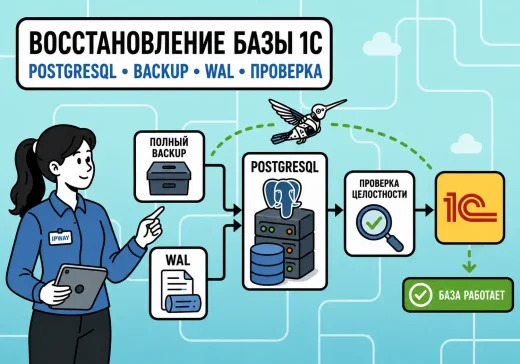
Резервная копия базы 1С нужна не сама по себе. Ее задача — позволить вернуть рабочую информационную базу после сбоя, ошибки администратора, неудачного обновления или повреждения данных….